Taiwei Shi
Senior Applied Scientist at Microsoft
Office of Applied Research
taiweishi@microsoft.com (work)maksimstw@gmail.com (personal)
Redmond, WA
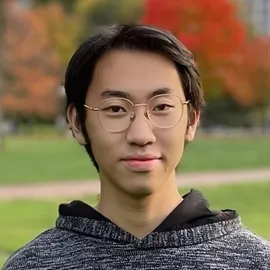
I'm a Senior Applied Scientist at Microsoft's Office of Applied Research, where I work on reinforcement learning, mid-training, and self-improvement of large language models.
I received my Ph.D. in Computer Science from the University of Southern California in 2026, advised by Jieyu Zhao. Before that, I studied Computer Science at Georgia Tech, where I was fortunate to work with Mark Riedl and Diyi Yang. I've also spent time at Microsoft Research and USC ISI.
My research focuses on building the cognitive core of intelligence: a system that continually learns, adapts, and improves through its own experience. Beyond a single agent, I envision a society of intelligent agents that teach, compete with, and build upon the legacy of one another, allowing intelligence to evolve and compound through collective experience, much like a civilization.
Recent
-
Joined Microsoft's Office of Applied Research as a Senior Applied Scientist.
-
Skill Reuse as Compression in Agentic RL accepted to EMNLP 2026 (main conference).
-
Defended my Ph.D. at USC, advised by Jieyu Zhao.
-
AdaRFT accepted to TMLR, and video-based reward modeling for computer-use agents accepted to ECCV 2026.
-
Gave a talk on Learning From Experience in Large Language Models at McGill NLP.
-
Detecting and filtering unsafe training data via data attribution accepted to ICML 2026.
-
CoAct-1 accepted to ICLR 2026, and the ERL code is now available.
-
Released Experiential Reinforcement Learning, with a Microsoft Research article and a talk at Microsoft Research.
-
WildFeedback accepted to ACL 2026 (main conference).
-
The Hallucination Tax of Reinforcement Finetuning at EMNLP 2025 Findings, STEER-Bench at EMNLP 2025, and SEA at COLM 2025.
Selected publications
All 20 papers-
Experiential Reinforcement Learning
arXiv 2026
Embeds an experience–reflection–consolidation loop into RL, so language models turn sparse feedback into lasting behavioral improvements — up to +81% in multi-step environments.
@misc{shi2026experientialreinforcementlearning, title={Experiential Reinforcement Learning}, author={Taiwei Shi and Sihao Chen and Bowen Jiang and Linxin Song and Longqi Yang and Jieyu Zhao}, year={2026}, eprint={2602.13949}, archivePrefix={arXiv}, primaryClass={cs.LG}, url={https://arxiv.org/abs/2602.13949}, } -
WildFeedback: Aligning LLMs With In-situ User Interactions And Feedback
ACL 2026 Annual Meeting of the Association for Computational Linguistics
Mines in-situ user feedback from real user–LLM conversations to build preference data, aligning models with what users actually want.
@misc{shi2025wildfeedbackaligningllmsinsitu, title={WildFeedback: Aligning LLMs With In-situ User Interactions And Feedback}, author={Taiwei Shi and Zhuoer Wang and Longqi Yang and Ying-Chun Lin and Zexue He and Mengting Wan and Pei Zhou and Sujay Jauhar and Sihao Chen and Shan Xia and Hongfei Zhang and Jieyu Zhao and Xiaofeng Xu and Xia Song and Jennifer Neville}, year={2025}, eprint={2408.15549}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2408.15549}, } -
Efficient Reinforcement Finetuning via Adaptive Curriculum Learning
TMLR 2026 Transactions on Machine Learning Research
An adaptive curriculum for reinforcement finetuning that keeps problems challenging but solvable, improving both training efficiency and final accuracy.
@misc{shi2025efficientreinforcementfinetuningadaptive,
      title={Efficient Reinforcement Finetuning via Adaptive Curriculum Learning},
      author={Taiwei Shi and Yiyang Wu and Linxin Song and Tianyi Zhou and Jieyu Zhao},
      year={2025},
      eprint={2504.05520},
      archivePrefix={arXiv},
      primaryClass={cs.LG},
      url={https://arxiv.org/abs/2504.05520},
}